Tirsdag 22. september lanserte Anthropic Claude Opus 5.5. Det er bare to måneder siden Opus 5 kom, og vi ventet en liten oppdatering. Endringene er større enn det. Opus 5.5 er den første modellen i den nye 5.5-familien, og Sonnet 5.5 og Haiku 5.5 kommer i løpet av de neste ukene.
Slik har vi jobbet til nå
Hos Raunic har vi fordelt arbeidet på flere modeller. Opus 5 og Sonnet har skrevet det meste av koden vår, blant annet i Raunic OS, systemet vi bruker til å håndtere henvendelser, leads og prosjekter. Fable har vi hentet inn når vi trenger mest tenkekraft, som når vi planlegger arkitektur og går gjennom kode før den går i produksjon.
Den fordelingen har fungert godt. Men Fable er en større og tyngre modell, så vi har vært nøye med når vi bruker den.
På nivå med Fable, til lavere pris
Mer interessant enn at Opus 5.5 slår Opus 5, er at den på flere områder også slår Fable 5.1. Ifølge Anthropic ligger den foran på agentisk koding, kunnskapsarbeid og bruk av datamaskin (computer use). Anthropic understreker selv at den ligger på nivå med Fable 5.1 på det meste, og at små forskjeller i testresultater sier mindre enn før.
Noen tall fra lanseringen:
- På Terminal-Bench 4.0, som måler koding i terminalen, får Opus 5.5 66,4 prosent på innstillingen extra high. Fable 5.1 får 55,8 og Opus 5 får 52,3.
- På GDPval-AA, som måler kunnskapsarbeid, får den 1846 Elo på max, mot 1735 for Fable 5.1 og 1708 for Opus 5.
- GitHub, som har testet modellen i VS Code, melder at den løste flere terminaloppgaver enn Opus 5 med under halvparten så mange steg.
Testresultater sier ikke alt. Men færre steg per oppgave merker man i hverdagen, både i tid og på fakturaen.
Billigere og raskere
Prisen har gått ned:
- input per million tokens (før 47 kr)
- 38 kr
- output per million tokens (før 237 kr)
- 190 kr
- lesing fra cache per million tokens (før 4,75 kr)
- 1,90 kr
- billigere enn Opus 5 på vanlige arbeidsmengder, ifølge Anthropic
- ~40 %
Omregnet fra dollar med Norges Banks kurs 24.09.2026 (1 USD = 9,49 kr). Anthropic fakturerer i dollar, så prisen i kroner følger valutakursen.
Anthropic anslår at vanlige arbeidsmengder blir rundt 40 prosent billigere å kjøre enn med Opus 5, med standardinnstillingene. Modellen skriver også svarene over 30 prosent raskere. For kundene våre betyr det at AI-løsningene vi bygger, blir billigere å drifte.
Merkes også på abonnementet
Du trenger ikke betale per token for å merke forskjellen. Vi bruker selv Claude Max, der du ikke betaler per token, men har en fast kvote som fylles opp i løpet av uka – en slags bøtte. Fordi Opus 5.5 bruker færre tokens per oppgave, og medium nå er standard, rekker bøtta lenger.
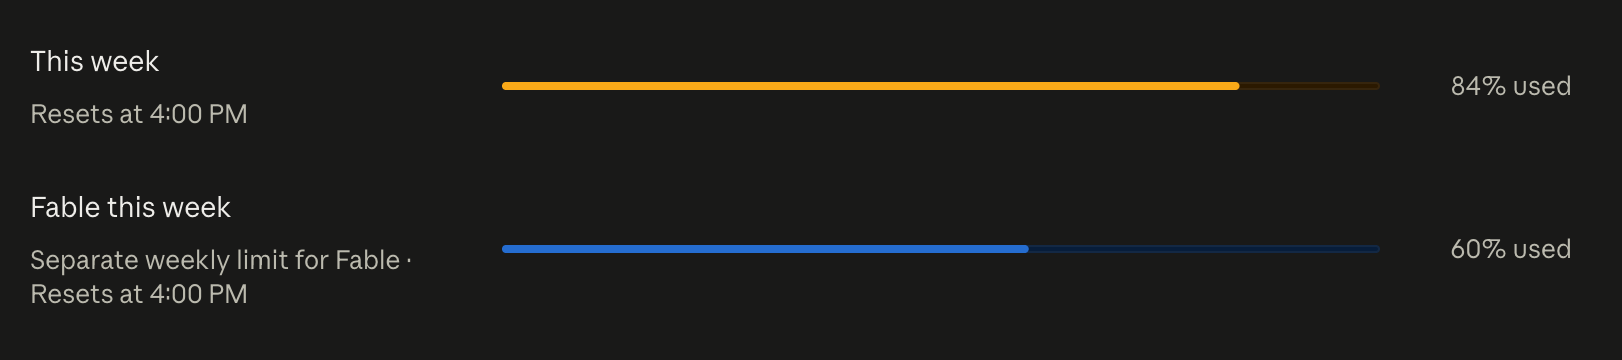
Da denne artikkelen ble skrevet, hadde vi brukt 84 prosent av ukekvoten på Max 20x. Med Opus 5 på high er vi ganske sikre på at vi hadde vært i taket allerede. Fable har i tillegg sin egen ukekvote, så jo mer av planleggingen og kodegjennomgangen Opus 5.5 kan ta, jo mer Fable-kapasitet har vi igjen til oppgavene som virkelig trenger den.
Medium er ofte nok
Med Opus 5.5 velger du selv hvor mye modellen skal tenke før den svarer. Du kan velge mellom low, medium, high, extra high og max. Jo høyere du går, jo grundigere blir svaret, men det koster også flere tokens og tar lengre tid.
På Opus 5 var high standardinnstillingen. Nå har Anthropic flyttet standarden ned til medium, og det har en god grunn. Ifølge Anthropics egne tester er Opus 5.5 på medium minst like god som Opus 5 på high, både til koding og kunnskapsarbeid. På flere kodeoppgaver kommer low nesten like langt, til en mye lavere pris.
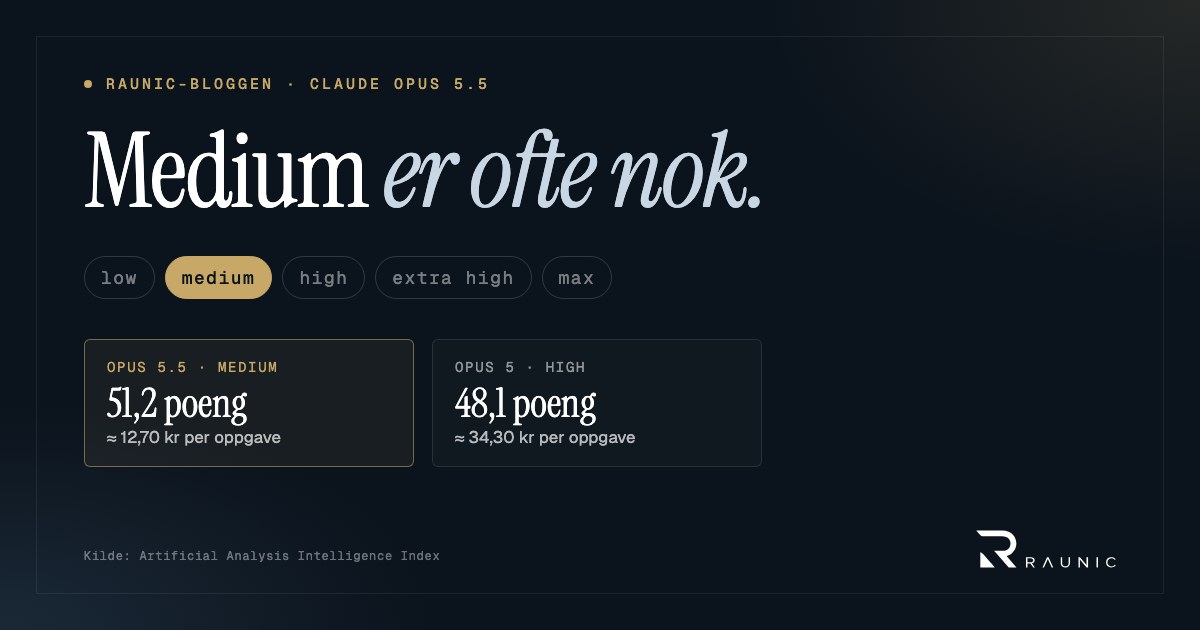
Tall fra den uavhengige indeksen til Artificial Analysis peker samme vei. Der fikk Opus 5.5 på medium 51,2 poeng, mot 48,1 for Opus 5 på high. Hver oppgave kostet om lag 12,70 kroner mot 34,30. Å skru helt opp til max ga rundt sju poeng mer, men kostet over fire ganger så mye.
Derfor slutter vi å skru opp til max av gammel vane. Medium er utgangspunktet vårt. High bruker vi på de vanskeligste problemene, og extra high og max sparer vi til lange og krevende oppgaver der vi faktisk ser at det gir et bedre resultat. Anthropic anbefaler dessuten å teste dette på egne oppgaver i stedet for å ta med seg innstillingene fra forrige modell. Det gjør vi.
Skriver mer som et menneske
Anthropic sier at Opus 5.5 setter det viktigste først, bruker mindre fagsjargong og følger skrivereglene du gir den. Vi har faste regler for hvordan tekst fra oss skal lyde, og en modell som følger dem uten å måtte minnes på det, sparer oss for mye etterarbeid.
Sikrere der det betyr noe
Opus 5.5 er bedre til å stå imot såkalt prompt injection. Det er når noen gjemmer instruksjoner i en e-post eller et dokument for å lure AI-en til å gjøre noe den ikke skal. Når AI leser henvendelser fra ukjente avsendere, er dette viktig. I en ny test fra Anthropic forsøkte Opus 5.5 rundt 85 prosent sjeldnere enn Opus 5 å bryte ut av rammene den skulle holde seg innenfor.
Modellen har sikkerhetsmekanismer på nivå med Fable 5.1, og Anthropic skriver at den har vannmerking for å oppfylle kravene i EUs AI-forordning. Hos oss gjelder uansett samme prinsipp som før: AI foreslår, mennesker godkjenner.
Andre nyheter
- Modellen tenker alltid. Opus 5.5 bestemmer selv hvor mye den skal tenke, og det kan ikke slås av. Du styrer det med innstillingen over. Anthropic skriver at man kan vurdere å fjerne gamle triks som «tenk grundig før du svarer» fra instruksjonene.
- Tydeligere underveis. På lengre oppgaver forteller modellen hva den har gjort, hva den har funnet og hva den trenger fra deg. Det gjør det lettere å følge med når den jobber selvstendig.
- Leser grafer bedre. Selv på laveste innstilling leser Opus 5.5 av tett pakkede grafer mer presist enn Opus 5 gjorde på høyeste. Det er nyttig for skjermbilder og PDF-rapporter.
- Fast mode. For dem som trenger svar raskt, finnes nå en hurtigmodus i API-et og Claude Code som er opptil 2,5 ganger raskere. Den er i forhåndsvisning og koster det dobbelte.
- Mer bruk i abonnementene. Femtimersgrensene er økt for Pro, Max, Team og Enterprise.
For dere som bygger på API-et, er det noen endringer å få med seg før dere bytter modell. Tenking kan ikke skrus av, og det går ikke lenger an å tvinge modellen til å bruke et bestemt verktøy. Eksisterende integrasjoner som gjør dette, får feilmelding. I beta kan du også legge til verktøy midt i en samtale uten å miste cachen, og selv bestemme når lange samtaler skal komprimeres.
Hva vi gjør nå
- Opus 5.5 blir hovedmodellen for utviklingen vår i Claude Code.
- Vi bruker medium som standard, og tester low og high opp mot det. Low er særlig interessant for løsninger med stort volum.
- Vi tester om Opus 5.5 kan ta over mye av planleggingen og kodegjennomgangen vi har brukt Fable til. Fable beholder vi der vi vil ha en ekstra runde.
- Når Sonnet 5.5 kommer, tester vi den på enklere oppgaver.
- Vi går gjennom løsningene vi drifter for kunder og ser hvor vi kan bytte modell og få ned kostnadene.
Vi deler gjerne hva vi finner ut underveis. Lurer du på hva dette kan bety for din bedrift, er det bare å ta kontakt.